字幕翻译
把生成或导入的字幕翻译成目标语言。可以在任务向导里与转写串成流水线,也可以单独用「翻译已有字幕」批量处理现成的 SRT 文件。
基本流程
- 启动台选「翻译已有字幕」(或在任何任务里勾选「翻译字幕」目标)
- 选择源语言、目标语言与翻译服务
- 选择输出内容:纯译文,或原文 + 译文双语字幕
- 可选:打开生成摘要,并指定一个 AI 服务(可以和翻译服务不同)。摘要先通读整份字幕,再注入后续 AI 翻译的提示词。短字幕会自动跳过。传统机翻 / Qwen-MT 读不到摘要,只作对照。
- 可选:在配置条指定本次使用的词库
- 开始批量翻译
翻译服务下拉按配置状态分组,已配置的排在前面。任一服务未配置时,去「翻译」页面完成配置即可(见下文)。
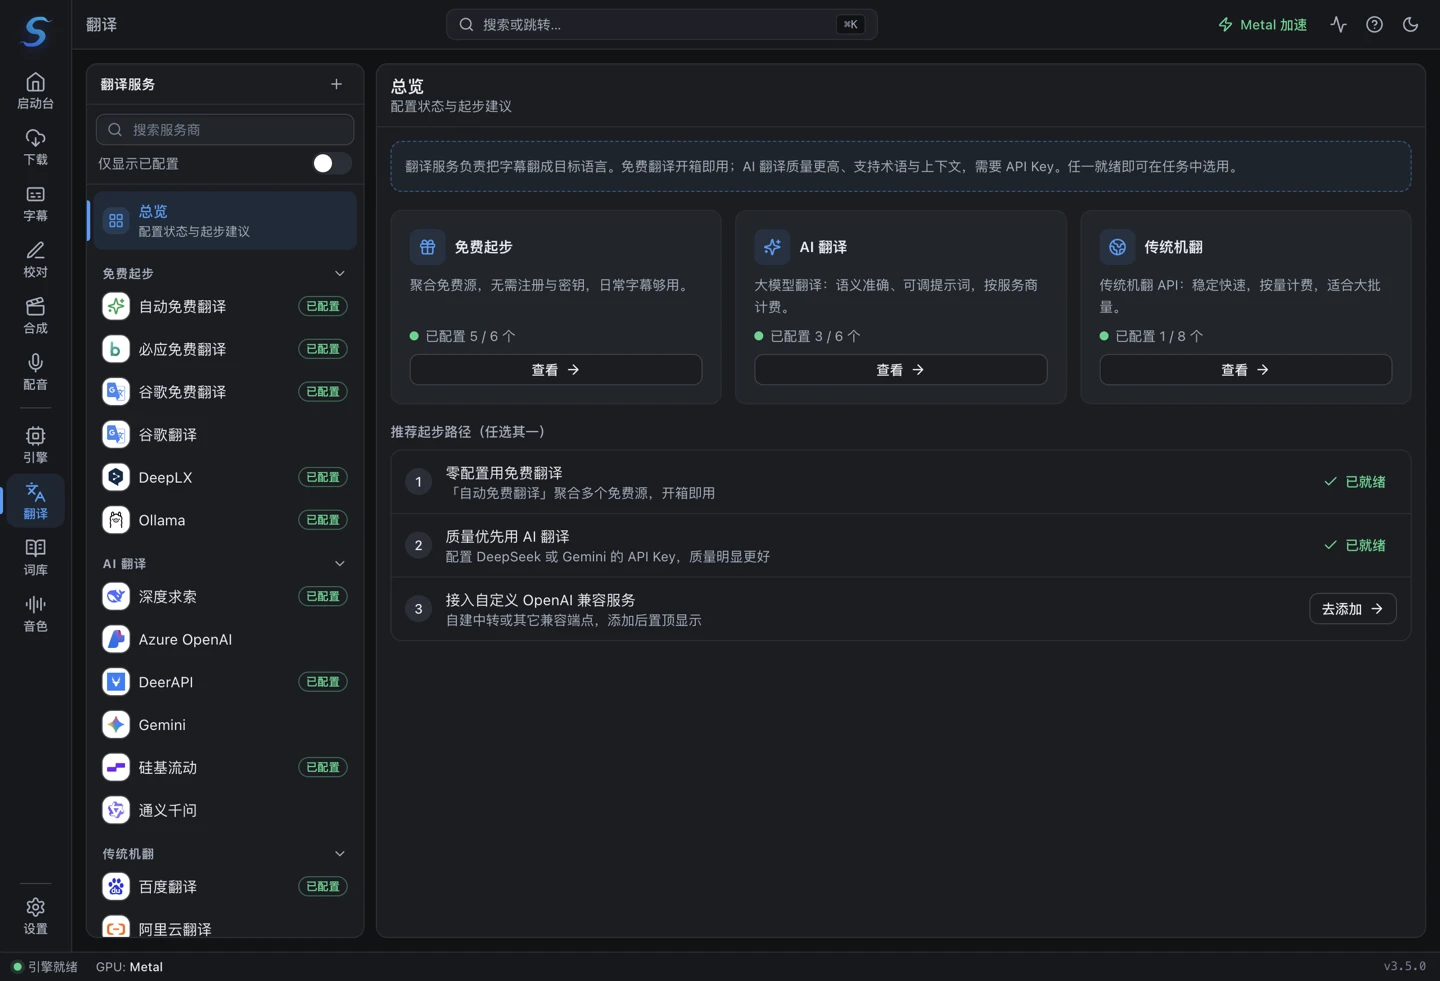
20 个翻译服务,三档选择
| 类别 | 服务 | 适合 |
|---|---|---|
| 免费起步 | 内置免费翻译(自动 / 必应 / 谷歌免费接口)、谷歌翻译、DeepLX、Ollama 本地大模型 | 零成本日常够用,开箱即用 |
| AI 翻译 | DeepSeek、Azure OpenAI、DeerAPI、Gemini、硅基流动、通义千问,以及任意 OpenAI 兼容 API | 语义准确、可调提示词,质量优先 |
| 传统机翻 | 百度、阿里云、火山、豆包、小牛、腾讯、讯飞、微软 | 稳定快速、按量计费,适合大批量 |
- 内置免费翻译支持多源自动回退与限速,一个源失效自动切下一个,无需注册与密钥
- 每个服务商的申请与配置步骤见翻译服务配置指南
AI 翻译的质量保障
AI(大模型)翻译质量高,但模型行为需要约束,妙幕内置了多层防护:
- 对齐防护:自动识别并修复模型合并 / 拆分字幕造成的译文错位,确保译文与原文一一对应;可开启「回显对齐校验」让模型对每条字幕同时返回原文回显与译文,系统据此检测修复
- 结构化输出:测试连接时自动探测服务商支持的结构化输出模式并写回配置,增强返回格式的可靠性
- 失败重试:只重试失败的批次,不浪费已成功的结果
- 思考模式开关:默认关闭思考让翻译更快更省;需要深度推理时可随时打开(自动按服务商下发对应参数)
术语表:专有名词翻译更统一
在「词库」页面维护术语表(品牌名、人名、专业词),翻译时命中的词条会自动注入提示词,多词库支持优先级排序与 CSV / TXT 导入导出。
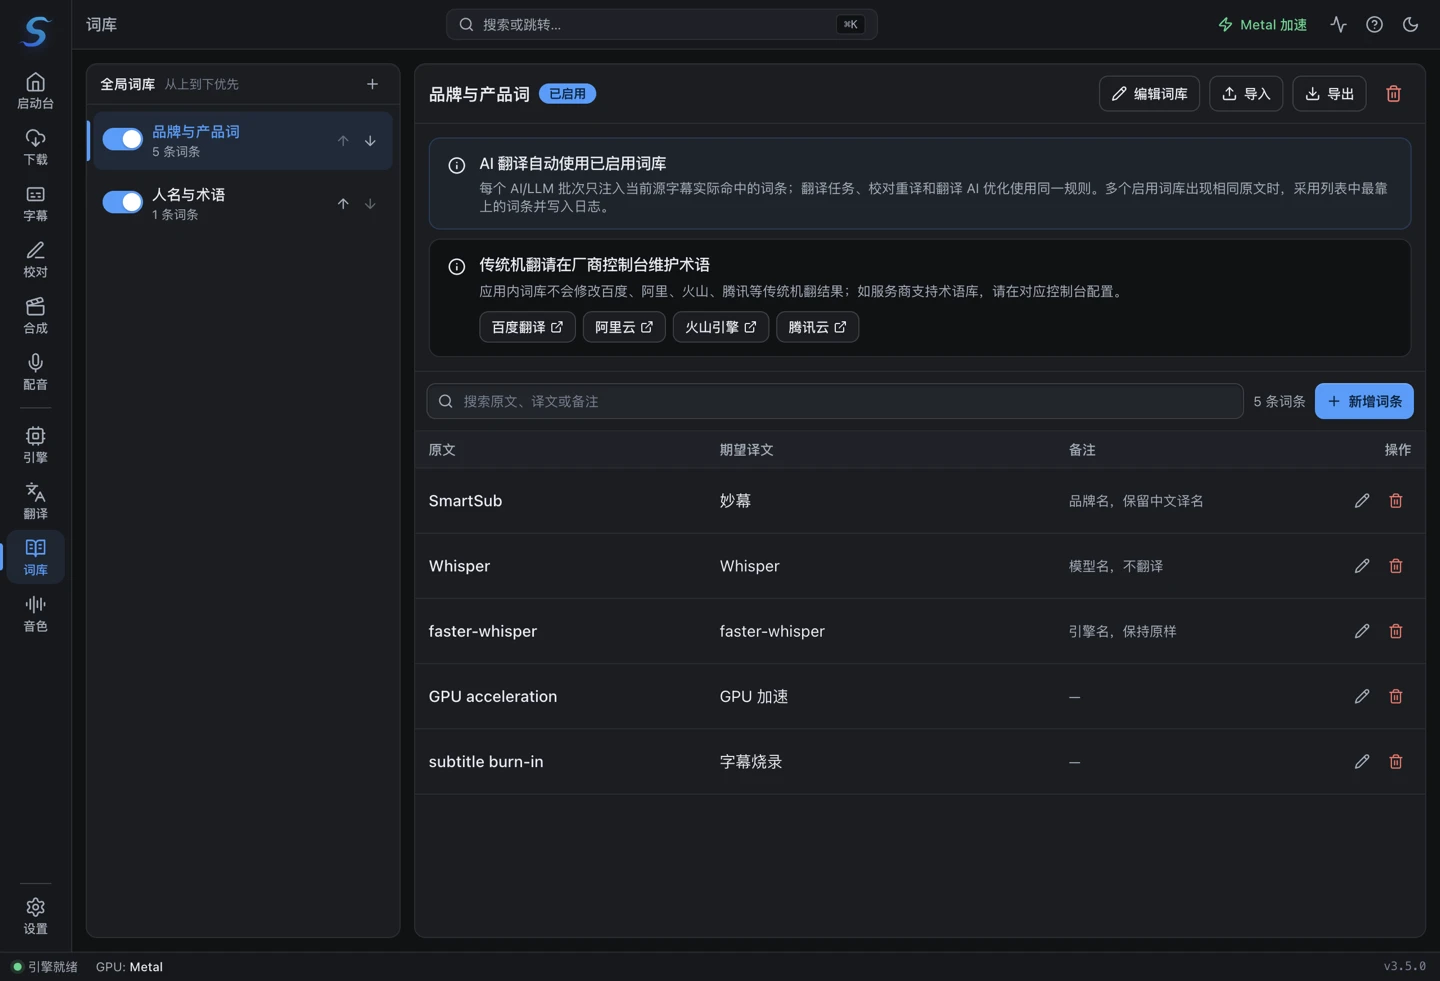
详见术语表。传统机翻(百度 / 阿里 / 火山 / 腾讯)的术语请在对应厂商控制台维护,应用内词库只作用于 AI 翻译。
批量与性能
- 批量翻译数量 / 批次并发数 / 请求间隔三个参数直接在服务配置页并排调节,大批量字幕翻译速度可数倍提升
- AI 翻译默认每批 20 条字幕:对常见字幕长度通常能保留足够上下文,又不会让回显 JSON 接近模型上下文上限;本地小模型建议从 5–10 条开始
- 云端 AI 默认并发 2 个批次;Ollama、Gemini 免费档和 SiliconFlow 等限流或本地场景默认更保守,可按 429、显存和响应速度调整
- AI 语义断句按 300–500 个词分窗,并复用服务商并发;3 分钟左右的语音通常会形成 1–3 个窗口,云端可并行处理
- 每个 AI 服务可配置自定义请求参数(String / Float / Boolean / Array / Object / Integer),界面直接添加修改、实时校验,支持导出导入,无需改代码
- AI 翻译结果受模型和提示词影响较大,可在提示词设置中调整模板
输出形式
- 纯译文:只保留翻译结果
- 原文 + 译文:双语字幕(上下两行),适合语言学习与对照检查
- 自定义翻译后的字幕文件名后缀,方便播放器识别语言轨
在高级设置的「字幕输出格式」中可同时勾选 SRT、VTT、ASS、LRC、TXT,例如一次翻译同时保存 SRT 和纯文本稿。各格式使用相同的纯译文或双语内容设置,不会重复调用翻译服务;校对保存也会同步更新本次任务的各格式输出。
生成并翻译任务中,格式选择同时用于需要保存的源字幕和译文。「不保存源字幕」仍然生效;翻译已有字幕时,只转换新生成的译文,不覆盖输入文件。多格式输出仍使用一个目标语言,不会同时翻译为多个语言。