字幕生成(语音转写)
把视频 / 音频里的人声转成带时间轴的字幕文件。这是妙幕流水线的第一环,支持批量处理、多引擎切换与硬件加速。
基本流程
- 在启动台选择「视频 → 原文字幕」(或任何包含转写的任务),把文件拖进任务向导
- 在「字幕设置」里选择语音模型、视频源语言与字幕格式
- 点「开始」批量处理,完成后字幕文件默认生成在视频同目录
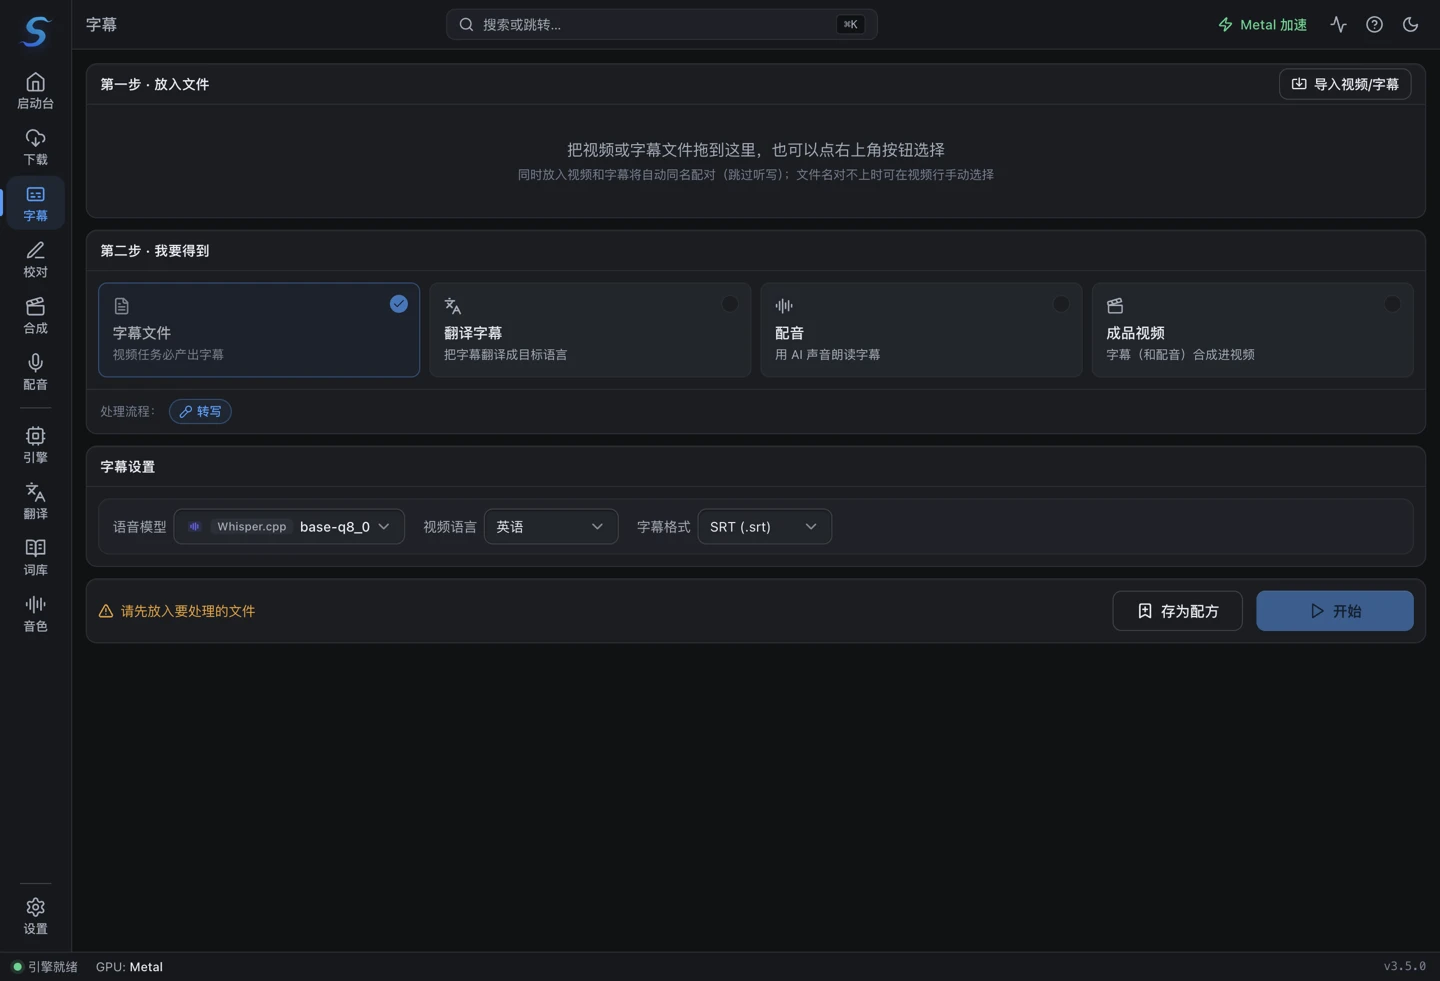
支持常见的视频(mp4 / mkv / mov / avi …)与音频(mp3 / wav / m4a / flac …)格式;并发任务数可在任务设置中调整。
同时保存多种字幕格式
「字幕输出格式」支持同时勾选 SRT、VTT、ASS、LRC 和 TXT,至少保留一种。例如同时选择 SRT + TXT,一次转写即可得到带时间轴的字幕和纯文本稿,不需要重复识别。每种格式沿用相同的文件名,仅扩展名不同。
选择多种格式不会增加转写或翻译调用次数。任务历史和自定义配方会保留格式选择;旧任务仍按原来的单格式设置运行。校对保存会同步更新本次任务导出的所有格式。
TXT 不含时间轴,LRC 只有起始时间;应用会保留内部带时间轴的字幕供校对、配音和合成使用。导入或配对的原字幕不会被格式转换覆盖。遇到文件名冲突或写入失败时,「导出字幕」阶段会报错,已生成的 SRT 会保留;修复路径或权限后可重试。
导出失败或取消后,重试只使用保存的字幕结果重新导出,不会再次转写或翻译;即使重开任务也会保留该断点。所有格式、时间轴缓存和校对元数据写入成功后,才清理未选择的中间 SRT。新建任务向导中的三类字幕任务均可直接选择输出格式。
八类转写引擎
转写引擎可以逐任务切换,在「引擎」页面统一安装与管理:
| 引擎 | 特点 | 运行方式 |
|---|---|---|
| whisper.cpp(内置) | 默认引擎,ggml 量化模型 + GPU 加速,低配电脑也能流畅跑 | 随应用内置,开箱即用 |
| faster-whisper | 基于 CTranslate2,速度更快、精度更高 | 自包含运行时(应用内下载) |
| FunASR | SenseVoice(中 / 英 / 日 / 韩 / 粤)与 Paraformer-zh,中文表现优秀 | 内置 sherpa-onnx,无需额外环境 |
| Qwen3-ASR | 通义千问语音识别(qwen3-asr-0.6b / 1.7b) | 内置 sherpa-onnx,无需额外环境 |
| FireRedASR | FireRedASR-AED large(中英),中文表现优秀 | 内置 sherpa-onnx,无需额外环境 |
| NVIDIA Parakeet | Parakeet TDT 0.6B v3,英文与 25 种欧洲语言,自动标点及大小写 | 内置 sherpa-onnx,无需额外环境 |
| 本地 Whisper CLI | 调用你自行安装的 whisper 兼容命令 | 使用系统已装命令 |
| 云端听写 | 9 家在线服务商,免 GPU 免模型,部分有免费额度 | 在线服务(音频上传到配置的端点) |
- 引擎选型与逐个安装说明见转写引擎总览
- 中文内容推荐 FunASR / FireRedASR;英文与欧洲语言可试 Parakeet;没有显卡且不想下载模型时推荐云端听写
- whisper 系模型怎么选(tiny 到 large、量化版本)见模型选择与导入
字幕效果档位
不想调参数的话,直接选效果档位:按「快速草稿 / 均衡 / 精细」等使用意图自动派生底层识别参数(VAD 切分、时间戳策略等),几乎无需手动调参。
需要精细控制时,任务高级设置提供:
- 每条字幕最大字数:有词级时间戳的引擎(whisper.cpp / faster-whisper / 云端听写)按真实词级时间重新成句;其余引擎按文本比例兜底拆分
- 断句设置:三态控制——严格不拆词 / 允许适度拆分 / 不限长度
- 中文去标点、简繁转换:中文字幕可选去除标点、简体繁体互转
时间轴质量
- 内置 whisper.cpp 引擎使用 Silero VAD 智能分段并设定最小显示时长,断句与时间对齐更自然
- 字幕显示按语音结束时间收敛,减少「字幕滞留」
- 超长音频(4 小时以上)自动在静音处分段处理,时间轴无缝合并,不再爆内存
角色分离
标准的「转写」和「转写 + 翻译」任务可在高级设置中开启角色分离。它会在转写、精修与翻译完成后,本地分析整段音频,把不同角色按时间轴对齐到每条字幕;处理耗时与音频长度大致成正比。
首次使用前需在「资源中心 → 本地多模型引擎」确认运行库可用并下载角色分离模型。角色信息默认只保存在应用内校对数据中,不会改变导出的字幕;需要交付可读标签时,可同时开启「将角色标签写入字幕文件」,初始输出使用 [Speaker 1] 等前缀。进入校对台后可以把编号改为真实角色名、纠正归属,并决定保存时是否写入当前角色名称。
当前版本暂不在一条龙向导、自定义配方及含配音 / 合成的流程中开放角色分离;这些流程会在角色元数据与配音音色映射完成后再接入。
用参考文稿校正转写
课程、演讲或成片已有 TXT / Markdown 文稿时,可导入参考文稿辅助转写校正。妙幕会在语音识别后按顺序对齐文稿与字幕,只把达到安全置信度的文本写回,并始终保留 ASR 生成的原始字幕条数和时码时间轴。
核心特性与安全边界
- 格式与编码:支持 UTF-8、UTF-16、GBK / GB18030 编码的
.txt、.md、.markdown文件(单个文稿最大支持 1 MiB) - 抗干扰对齐:智能跨过未念出的标题、列表、标点符号与舞台说明,平滑处理文稿与字幕分句粒度不一致的情况
- 高安全阈值与保底回退:低置信度片段保持原识别文本;文稿不存在、被移动或校验失败时整项安全回退,绝不导致任务中断或失败
- 全流程透传:校正后的文本无缝进入后续的翻译、校对、TTS 配音与视频合成环节
多视频独立文稿匹配
在批量处理课程集、多集视频或长篇系列内容时,支持每个视频对应独立的专属参考文稿(如 01.mp4 ↔ 01.txt、02.mp4 ↔ 02.md),彻底避免多视频共用单份文稿导致的错位与污染。
1. 智能自动配对规则
系统在导入时会自动执行多策略配对算法:
- 主干同名精准配对:如
lesson01.mp4 ↔ lesson01.txt(或.md) - 语言/修饰前缀配对:如
lesson01.mp4 ↔ lesson01.zh.md或lesson01.script.txt - 单文件容错配对:当只有单个视频与单份文稿时,即使文件名不同也会自动关联,免去手动重命名步骤
2. 便捷的导入方式
- 拖拽导入:可直接将多个视频和文稿文件(或包含它们的文件夹)同时拖入任务区域,系统会自动分类并就地完成配对,并弹出配对结果提示
- 点击「导入」按钮:在任务页面顶部工具栏、空态引导卡片中点击「导入」(或使用快捷键
⌘O/Ctrl+O),弹出的文件选择器支持多选,可同时选取音视频与文稿文件
3. 优先级与就近继承机制
文稿匹配采用三级就近继承逻辑:
- 专属文稿(视频行内):优先级最高。配对成功的视频行会显示高亮的「
文稿:文件名」标签胶囊;点击可随时更换文稿、移除文稿或设为跳过匹配 - 全局文稿(顶部工具栏):在顶部工具栏「参考文稿」设置全局兜底文稿。未单独指定文稿的视频行会显示虚线「
全局文稿:文件名」胶囊,默认继承此文稿 - 纯 ASR 语音识别:未配置任何文稿(或主动设为跳过文稿)的视频,将直接使用正常的语音识别结果,绝不阻断任务开始与执行
4. 普通任务与向导配方模式全覆盖
- 普通任务模式(
/tasks/[type]):列表视图与网格视图直观呈现文稿胶囊,支持行内一键管理 - 向导与自定义配方模式(TaskWizard):媒体区提供清晰的文稿绑定槽位与文稿池清单,底部的处理流程阶段链会实时统计文稿匹配覆盖率(如
3/3 已配置文稿);保存配方时保持纯净模板,再次使用时同样支持批量同名文稿自动装配
GPU 加速
| 平台 | 加速后端 |
|---|---|
| Windows / Linux + NVIDIA | CUDA(应用内下载) |
| Windows / Linux + AMD / Intel | Vulkan(已内置) |
| macOS Apple 芯片 | Core ML / Metal |
| 任意平台 | CPU 自动回退 |
无需手动安装 CUDA Toolkit,详见 GPU 加速。
实用细节
- 自定义字幕文件名:按模板生成文件名(如
视频名.zh.srt),方便不同播放器自动挂载识别 - 官方字幕优先:经视频下载获取的在线视频若带官方字幕,会自动配对,无需再转写
- 误命名兼容:导入的字幕文件即使扩展名不对,也会自动探测真实格式
- 模型完整性校验:faster-whisper 模型加载前自动校验完整性,避免残缺文件导致的转写异常
下一步
- 转写完成后翻译字幕或进校对台核对
- 高频场景照做:播客 / 会议录音批量转文字